Preços de modelos de IA
Os modelos de IA da Zenifra podem ter preços diferentes conforme o tipo e o volume de uso. Antes de enviar uma requisição, consulte o catálogo atual para identificar a unidade de cobrança, o preço padrão, possíveis faixas por janela de contexto e horários off-peak.
Os preços exibidos no Console e no catálogo público são a fonte atual para estimativas. Não fixe valores comerciais no código da sua aplicação, porque modelos, limites e preços podem mudar.
Consultar o catálogo
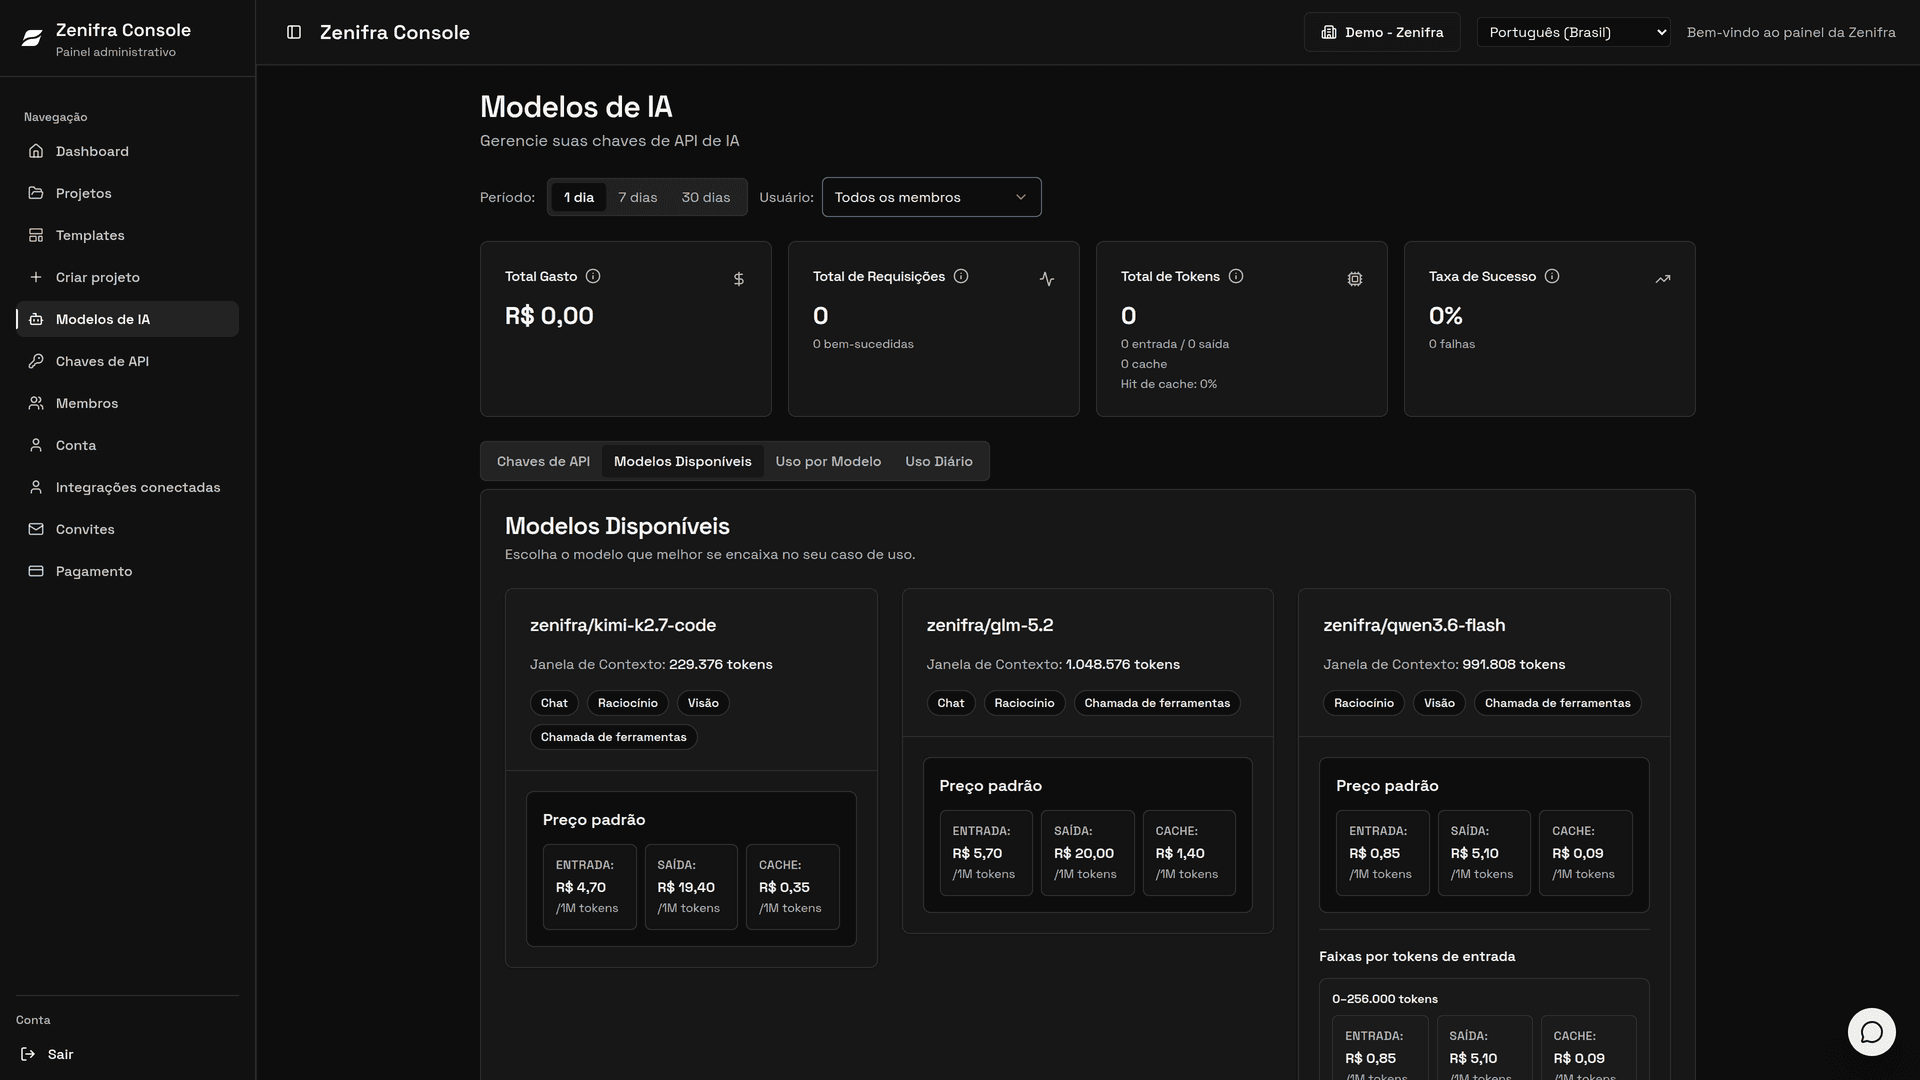
O catálogo público está disponível em:
GET https://ai.zenifra.com/v1/modelsCada modelo informa sua janela de contexto (context_length), limite máximo de saída (max_output_tokens), capacidades e preços aplicáveis. Exemplo de um modelo cobrado por tokens:
{
  "id": "zenifra/deepseek-v4-pro",
  "object": "model",
  "owned_by": "zenifra",
  "context_length": 1000000,
  "max_output_tokens": 393216,
  "pricing": {
    "input": 8.5,
    "output": 17,
    "cache_read_input": 0.7,
    "cache_min_input_tokens": 1024,
    "unit": "per_million_tokens",
    "off_peak": {
      "hours_utc": "14:00-00:00",
      "input": 4.3,
      "output": 8.5,
      "cache_read_input": 0.35
    }
  }
}
Os preços são em reais (R$). Os valores com unidade per_million_tokens representam preço por 1 milhão de tokens. A cobrança efetiva considera a quantidade realmente utilizada.
Preço padrão ou peak
Os campos diretamente dentro de pricing representam o preço padrão, também chamado de peak:
input: tokens enviados ao modelo;output: tokens gerados pelo modelo;cache_read_input: tokens de entrada reutilizados do cache;cache_min_input_tokens: quantidade mínima de tokens necessária para o cache, quando aplicável.
Se o modelo não apresentar off_peak, o preço padrão vale durante todo o dia. Se não apresentar context_tiers, o mesmo preço padrão vale para qualquer requisição dentro dos limites publicados.
Preço off-peak
Alguns modelos oferecem preços reduzidos em horários específicos. Quando disponível, o objeto pricing.off_peak informa os preços e a janela em UTC.
Por exemplo:
{
  "hours_utc": "14:00-00:00",
  "input": 4.3,
  "output": 8.5,
  "cache_read_input": 0.35
}
Para clientes no horário UTC−3, 14:00-00:00 UTC corresponde a:
11:00-21:00 UTC−3O Console e a Homepage mostram essa conversão para UTC−3. O payload da API continua usando UTC para evitar ambiguidades em integrações. Fora da janela off-peak, aplicam-se os preços padrão.
Preço por faixa de contexto
Alguns modelos mudam de preço conforme a quantidade de tokens de entrada da requisição. Quando isso acontece, pricing.context_tiers descreve faixas inclusivas:
{
  "basis": "input_tokens",
  "context_tiers": [
    {
      "min_input_tokens": 0,
      "max_input_tokens": 128000,
      "input": 1,
      "output": 2,
      "cache_read_input": 0.1
    },
    {
      "min_input_tokens": 128001,
      "max_input_tokens": 1000000,
      "input": 1.5,
      "output": 3,
      "cache_read_input": 0.15
    }
  ]
}
basis: "input_tokens" significa que o tier é escolhido pela quantidade de tokens de entrada. Não some o limite máximo de entrada com o limite máximo de saída para determinar a janela: a requisição completa deve respeitar context_length.
Se context_tiers não estiver presente, não existe uma mudança de preço por faixa configurada para aquele modelo. Não deduza tiers apenas porque o modelo possui uma janela de contexto grande.
Como estimar o custo
Para um modelo sem tiers:
custo de entrada = tokens de entrada × preço de entrada / 1.000.000
custo de saída = tokens de saída × preço de saída / 1.000.000
custo de cache = tokens de cache × preço de cache / 1.000.000
Quando existir um tier, use os preços da faixa correspondente à quantidade de tokens de entrada. Quando a requisição ocorrer dentro da janela off-peak, use os preços de off_peak conforme indicado no catálogo.
Os valores exibidos são adequados para estimativas. O custo registrado no Console é a referência para o uso efetivamente processado.
Imagem e outras unidades
Modelos de geração de imagem podem usar:
{
  "pricing": {
    "input": 0.003,
    "output": 0.075,
    "cache_read_input": null,
    "unit": "per_image"
  }
}
Nesse caso, os valores são cobrados por imagem, não por tokens. Sempre leia pricing.unit antes de calcular uma estimativa.
Próximos passos
Última atualização em
Como começar com IA
Crie uma API key, defina um budget e faça sua primeira requisição OpenAI-compatible na oferta de IA da Zenifra.
Modelo de decisão
Use o modelo de decisão zenifra/kev-4b para classificar textos com probabilidades, respostas sim/não e notas em escala, cobrado só pelos tokens de entrada.